Project HydraFusion: 멀티모델 오케스트레이션으로 frontier 품질 달성
Dokebi · 2026년 10월 29일 · #tech #ai
소개
GitHub Copilot은 개발자에게 작업에 가장 적합한 모델을 제공하는 것을 목표로 해왔습니다. 올해 초에는 작업을 분석해 최적의 모델을 자동으로 매칭하는 Auto model selection을 출시했고, 이제 한 단계 더 나아가 Project HydraFusion을 연구 프리뷰로 공개했습니다.
HydraFusion은 단일 모델을 고르는 것을 넘어, 런타임에서 여러 모델을 오케스트레이션하여 frontier 수준의 품질을 더 낮은 비용으로 달성하는 것을 목표로 합니다. 개발자는 HydraFusion을 일반 모델처럼 선택하면 되고, 내부적으로는 작업에 맞는 워크플로를 자동으로 구성합니다.
HydraFusion이란?
HydraFusion은 런타임 모델 오케스트레이션을 통해 frontier 지능을 제공하는 연구 프리뷰 기능입니다. 하나의 실행 계획을 세우고, 여러 제공자의 모델 중에서 초안 작성(draft), 비평(critique) 및 수정(revise), 혹은 더 강력한 모델로의 캐스케이드(cascade)를 선택하여 작업을 완료합니다.
GitHub Copilot의 전체 전략인 로컬/클라우드/복합 모델 간 자동 시맨틱 라우팅에서 핵심 역할을 담당하며, 그 복잡성은 개발자에게 노출되지 않습니다.
세 가지 실행 패턴
HydraFusion은 각 요청에 대해 다음 세 가지 실행 패턴 중 하나를 선택합니다.
- Single: 하나의 선택된 모델이 작업을 직접 해결합니다. 속도와 효율이 중요한 경우에 사용됩니다.
- Cascade: 효율적인 모델이 초안을 작성하고, 품질 게이트가 이를 수용할지 더 강력한 모델로 에스컬레이션할지 결정합니다.
- Critique: 한 모델이 초안을 작성하고, 다른 모델 패밀리의 독립적인 읽기 전용 비평가가 검토(Rubber Duck과 동일한 패턴)한 뒤, 초안 작성 모델이 한 번 수정합니다.
각 패턴은 품질 대비 비용의 서로 다른 트레이드오프를 다룹니다. Single은 한 모델로 충분할 때, Cascade는 효율적인 모델에 첫 시도를 주면서도 강한 추론으로의 경로를 유지할 때, Critique은 추가 시도보다 독립적인 검토가 더 유용한 작업에 사용됩니다.
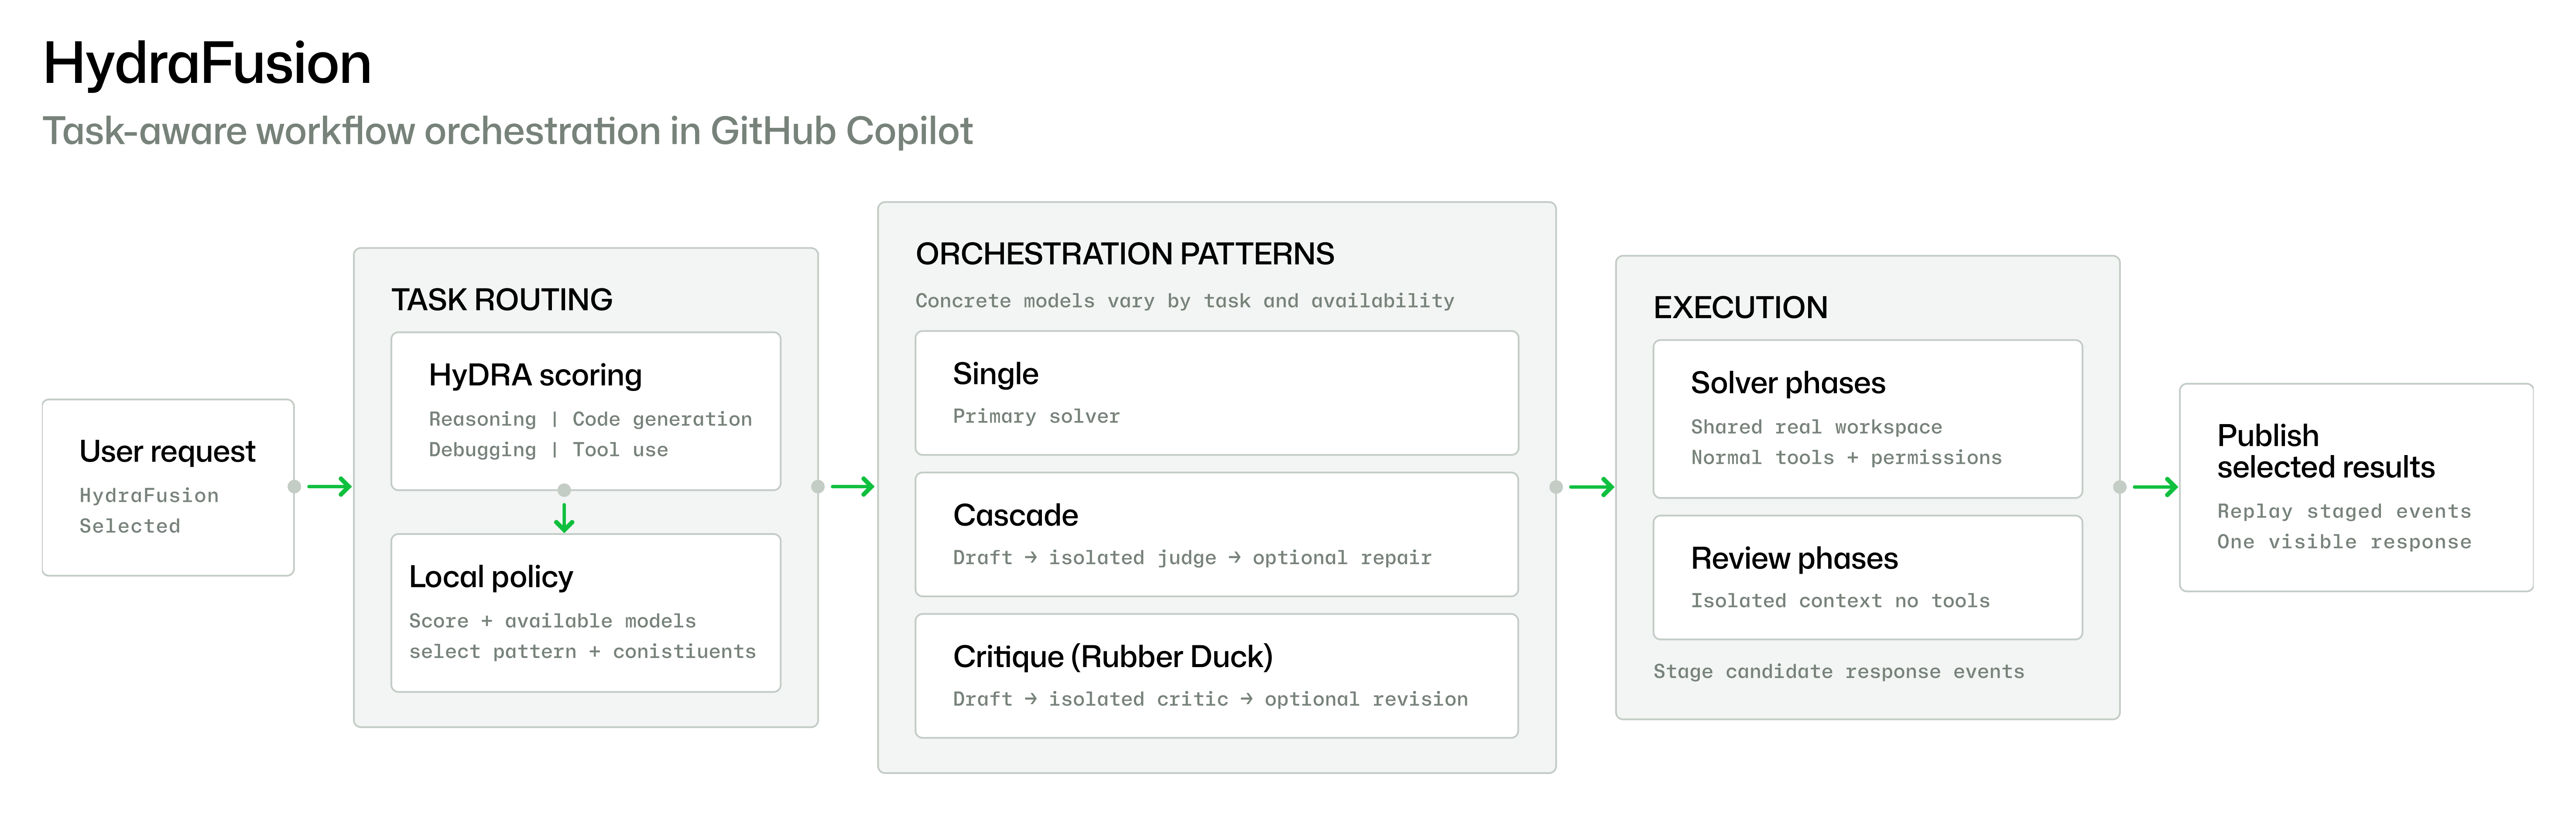
Figure 1. HydraFusion 아키텍처
적응형 멀티모델 오케스트레이션
개발자는 이미 수동으로 모델을 조율합니다. 작업에 맞는 모델을 고르고, 다른 모델에게 검토를 요청하거나, 어려운 문제를 더 강력한 모델로 에스컬레이션합니다. HydraFusion은 이 익숙한 과정을 런타임으로 가져옵니다. 한 번 HydraFusion을 선택하면 작업에 집중할 수 있고, 모델과 워크플로 관리는 뒤에서 처리됩니다.
핵심은 선택성(selectivity)입니다. 일부 코딩 작업은 직접 해결할 수 있지만, 다른 작업은 검토, 수정, 에스컬레이션의 이점을 얻습니다. HydraFusion은 각 요청을 평가하여 요구사항을 충족할 것으로 예상되는 가장 단순한 워크플로를 선택하고, 결과 개선이 예상될 때만 추가 모델 호출을 사용합니다.
모델 프론티어가 발전함에 따라 HydraFusion도 함께 발전합니다. GitHub Copilot에 새 모델이 추가되면 평가 후 모델 풀에 통합할 수 있어, 각 모델의 강점을 가장 적합한 작업에 활용할 수 있습니다.
HydraFusion의 5가지 운영 원칙
적응형 멀티모델 오케스트레이션을 신뢰할 수 있는 코딩 경험으로 만들기 위해 HydraFusion은 다섯 가지 운영 원칙을 중심으로 설계되었습니다.
- Complete accounting (완전한 회계): 초안, 비평, 수정, 에스컬레이션, 재시도, 폴백을 포함한 모든 워크플로 레그의 비용과 사용량을 집계합니다.
- Bounded execution (제한된 실행): 각 레그에 명시적인 타임아웃과 취소 동작을 부여하여 실행과 비용을 정의된 한도 내로 유지합니다.
- Isolated review (격리된 검토): 검토 단계는 도구 없는 격리된 컨텍스트에서 실행되고, 솔버 단계는 공유 워크스페이스와 일반 권한 인식 에이전트 루프를 사용합니다. 이를 통해 모델이 저장소를 수정하지 않고 독립적으로 작업을 평가할 수 있습니다.
- Fail-safe application (안전한 적용): 워크플로가 취소되거나 검증에 실패하면 패치를 적용하지 않아, 불완전한 변경이 저장소에 도달하는 것을 방지합니다.
- Validated routing (검증된 라우팅): 실행 시작 전에 워크플로 정의, 모델 바인딩, 폴백 동작, 모델 가용성을 검증합니다.
이 원칙들 덕분에 멀티모델 오케스트레이션이 저장소 수준의 작업에 실용적으로 적용됩니다. 런타임은 각 레그의 역할, 결과, 비용, 지연시간, 진단 정보를 기록하여 실행 후 워크플로를 이해할 수 있게 하고, 개발자에게는 하나의 일관된 응답과 권한 인식 변경 세트가 전달됩니다.
진행 상황 표시: 미완성 작업은 보여주지 않기
- 오늘: 워크플로 단계를 보여주지만, 하나의 일관된 결과를 반환할 때까지 중간 초안을 보류합니다.
- 이유: 그 초안들은 검토, 수정, 폐기될 수 있으므로 실시간으로 보여주면 미완성 작업이 최종 결과처럼 보일 수 있습니다.
- 배우는 점: 충분한 가시성 없이 기다리는 것은 개발자에게 실제 트레이드오프입니다.
- 다음: 연구 프리뷰 피드백을 바탕으로 더 나은 진행 상황 업데이트를 적극적으로 탐색 중입니다.
벤치마크 결과
고정된 HydraFusion 정책은 세 가지 에이전트 코딩 벤치마크 — TerminalBench 2.1, DeepSWE, CheckpointBench(실제 GitHub Copilot 세션 기반 내부 벤치마크) — 에서 Claude Opus 5와 GPT-5.6 Sol을 비교 기준선으로 평가되었습니다. 모든 정책은 동일한 작업 입력, 도구, 실행 한도, 가격 가정, 채점 조건, 누락 결과 처리를 사용했습니다.
평가 지표는 검증된 작업 품질(정확히 답변된 것으로 확인된 작업의 비율)과 완전한 추정 워크플로 비용입니다. 비용 회계에는 초안, 비평, 수정, 에스컬레이션, 재시도, 폴백을 포함한 모든 호출된 레그가 포함되었습니다.
| 벤치마크 | Opus 5 대비 비용 | Opus 5 대비 품질 |
|---|---|---|
| TerminalBench 2.1 | 67% 낮음 | +4.9 포인트 |
| DeepSWE | 36% 낮음 | -1.5 포인트 |
| CheckpointBench | 65% 낮음 | -0.1 포인트 |
표 1. Opus 5 대비 HydraFusion의 품질과 비용 (세 가지 에이전트 벤치마크)
TerminalBench 2.1에서는 검증된 작업 품질이 4.9 포인트 향상되고 추정 비용이 67% 낮아졌습니다. DeepSWE에서는 Opus 5 대비 1.5 포인트 이내의 품질을 유지하면서 비용을 36% 절감했고, CheckpointBench에서는 0.1 포인트 이내의 품질을 65% 낮은 비용으로 달성했습니다.
TerminalBench 2.1
터미널 환경에서 복잡한 다단계 작업에 대한 코딩 에이전트를 평가합니다.
DeepSWE
대규모 코드베이스 탐색, 파일 간 의존성 이해, 엔드투엔드 수정이 필요한 도전적인 저장소 수준 소프트웨어 엔지니어링 작업을 평가합니다. HydraFusion은 Opus 5 대비 1.5 포인트 이내의 품질을 유지하면서 비용을 36% 절감하여, 복잡한 실제 엔지니어링 작업에서 매력적인 품질-비용 트레이드오프를 보여줍니다.
CheckpointBench
실제 GitHub Copilot 에이전트 코딩 세션에서 큐레이션된 내부 멀티턴 벤치마크입니다. 각 대화는 특정 공개 저장소와 불변 커밋에 고정되어 모든 세션이 재생 가능합니다. 언어, 작업 유형, 난이도에 걸쳐 균형 잡힌 평가 세트로, 실제 프로덕션 에이전트 세션을 밀접하게 반영합니다. HydraFusion은 65% 낮은 비용으로 Opus 5 대비 0.1 포인트 이내의 품질을 달성했습니다.
지금까지 HydraFusion의 추론 및 작업 해결 능력은 Opus와 같거나 더 좋습니다.
— Microsoft Principal Software Engineer
HydraFusion 튜닝: Hill-climbing
HydraFusion의 라우팅 정책은 개발자들이 GitHub Copilot에서 실제 코딩 작업을 수행하는 방식을 바탕으로 형성되었습니다. 이를 재현 가능하게 만들기 위해 CheckpointBench를 실제 Copilot 코딩 세션 궤적에서 큐레이션했습니다. HydraFusion은 CheckpointBench, DeepSWE, TerminalBench 2.1 전반에 걸쳐 반복적으로 개선되었으며, 단일 벤치마크가 아닌 평가 세트 전반에서 최적화되었습니다.
기능별 점수는 후보 라우팅 정책을 비교하는 일관된 기준을 제공했습니다. 임계값을 수동으로 튜닝하는 대신 빔 서치(beam search)를 사용해 최적의 결정 정책을 구축했습니다. 각 후보는 품질, 비용, 실패 모드에 대해 고정된 기준선과 비교 측정되어, 개선 사항이 안정적인 기반 위에서 평가되었습니다.
TerminalBench 2.1은 가장 완전한 실행 시퀀스를 제공하여 이 반복적 개선의 가장 명확한 뷰를 제공합니다. 8월 11일부터 8월 25일 사이에 평가 하네스의 두 가지 운영 실패로 인해 유효하지 않은 실행이 발생했으며, 이는 성능 추세에서 제외되고 수정된 후 계속해서 개선이 이어졌습니다.
연구 프리뷰 사용 방법
HydraFusion은 GitHub Copilot의 모든 플랜 사용자에게 /experimental을 통해 GitHub Copilot CLI에서 사용할 수 있습니다. 사용량은 HydraFusion이 사용하는 모델들이 소비한 토큰을 기준으로 각 모델의 표준 요율로 과금됩니다.
Copilot CLI에서 시도하는 방법:
/update를 실행해 최신 버전 설치/experimental on실행/model실행 후HydraFusion (Research Preview)선택
피드백은 GitHub Community에 게시해 주세요.
이 프리뷰에서는 첫 턴, 단일 프롬프트 코딩 작업이 가장 좋은 시작점입니다. 더 긴 반복 세션에서의 강력한 멀티턴 성능은 다음 단계로 집중할 예정입니다. Copilot CLI의 /feedback 또는 GitHub Community 토론을 통해 어디서 뛰어나고 어디서 부족한지, 다음에 무엇을 보고 싶은지 공유해 주세요.
결론
HydraFusion은 "최고의 모델 선택"에서 "각 작업을 해결하는 최선의 방법을 동적으로 구성"으로의 전환을 시도합니다. frontier 지능과 런타임 오케스트레이션을 결합함으로써 코딩 에이전트의 다음 실질적 성능 향상을 만들어내는 것이 목표입니다. 벤치마크 결과는 비용을 크게 줄이면서 frontier 수준의 품질에 도달할 수 있음을 보여주며, 연구 프리뷰를 통해 실제 개발자 워크로드에서의 효과를 검증해 나갈 예정입니다.
원문: Project HydraFusion: Frontier quality via multi-model orchestration (GitHub Blog)